Introduction aux méthodes de Monte-Carlo
Les méthodes de Monte-Carlo
Des méthodes numériques qui utilisent le hasard pour résoudre des problèmes.
- calcul numérique d’intégrales, en grande dimension ;
- équations différentielles et aux dérivées partielles ;
- simulation de systèmes physiques (neutrons, aimants, gaz…) ;
- statistiques, apprentissage, finance, synthèse d’images…
Le principe en une phrase. Remplacer un calcul difficile par une moyenne de tirages aléatoires faciles à produire.
Plan du cours
- Simulation de variables aléatoires : de
rand()à n’importe quelle loi. - Simulation de chaînes de Markov : loi invariante, exemples en finance et en physique.
- Monte-Carlo pour l’intégration : calcul de \(\pi\), loi des grands nombres et TCL, erreur, réduction de variance.
- Monte-Carlo pour la simulation : le modèle d’Ising et l’algorithme de Metropolis-Hastings.
Partie 1 Simulation de variables aléatoires
Qu’est-ce que simuler ?
Simuler une variable aléatoire \(X\) à valeurs dans un ensemble \(E\), c’est disposer d’un programme dont chaque exécution renvoie une valeur de \(E\) distribuée selon la loi de \(X\).
Des appels successifs renvoient des réalisations indépendantes.
Un générateur : un point
Supposons que l’on dispose d’un générateur de points au hasard dans le carré rouge. Ce point a-t-il été tiré uniformément ?
Un générateur : vidéo
Et ceux-là ? On ne peut juger un générateur qu’à travers beaucoup de points.
Trois générateurs : première image
Trois générateurs de points dans le carré. Lequel est uniforme ?
Trois générateurs : vidéo
Trois générateurs de points dans le carré. Lequel est uniforme ?
Le comportement d’un générateur est déterminé par le comportement statistique de la suite des points qu’il produit.
La brique de base : les générateurs pseudo-aléatoires
- Tous les langages fournissent des nombres « pseudo-aléatoires » uniformes sur \([0,1]\) :
rng = np.random.default_rng(graine)puisrng.random().
- Un générateur pseudo-aléatoire est une suite déterministe \(a_{n+1} = g(a_n)\), issue d’une condition initiale \(a_0\) : la graine.
- Cette suite doit avoir les propriétés statistiques d’une suite i.i.d. uniforme :
- uniformité : pour tout intervalle \(A \subset [0,1]\), \(\quad\dfrac{1}{n}\displaystyle\sum_{i=1}^{n} \mathbf{1}_{A}(a_i) \xrightarrow[n\to\infty]{} |A|\) ;
- indépendance : la suite doit passer des tests statistiques (paires, triplets, …).
Bien que déterministe, la suite doit être indiscernable, statistiquement, d’un vrai tirage au hasard.
Exemple : les générateurs congruentiels linéaires
\[ x_{n+1} = (a\,x_n + c) \bmod m, \qquad u_n = \frac{x_n}{m} \in [0,1[. \]
- même graine \(\Rightarrow\) même suite : reproductibilité ;
- période au plus \(m\) ;
- le générateur C de la vidéo : \(a = 37\), \(c = 1\), \(m = 2^{14}\).
Aujourd’hui : Mersenne Twister (module random, période \(2^{19937}-1\)), PCG64 (numpy).
RANDU : première image
RANDU (IBM, années 1960) : \(x_{n+1} = 65\,539\,x_n \bmod 2^{31}\). Les triplets \((u_n, u_{n+1}, u_{n+2})\) semblent remplir le cube…
RANDU : vidéo
RANDU (IBM, années 1960) : \(x_{n+1} = 65\,539\,x_n \bmod 2^{31}\). Les triplets \((u_n, u_{n+1}, u_{n+2})\) semblent remplir le cube…
mais \(u_{n+2} - 6u_{n+1} + 9u_n\) est toujours entier.
Le savoir-faire du simulateur
L’ordinateur fournit des uniformes sur \([0,1]\).
Tout le reste se construit à partir de là :
- lois discrètes, exponentielle, gaussienne, … ;
- points uniformes dans un domaine compliqué ;
- trajectoires de chaînes de Markov.
Dans toute la suite, rand() renvoie un tirage uniforme sur \([0,1]\), indépendant des tirages précédents.
Variables aléatoires à valeurs finies
Soit \(X\) à valeurs dans \(\{0, \dots, n\}\) avec \(\mathbb{P}(X = k) = p_k\).
- \(U \leftarrow\)
rand() - \(k \leftarrow 0\), \(\;p \leftarrow p_0\)
- tant que \(U > p\) :
- \(k \leftarrow k + 1\)
- \(p \leftarrow p + p_k\)
- renvoyer \(k\)
Idée : découper \([0,1]\) en intervalles de longueurs \(p_0, p_1, \dots, p_n\).
Avec \(s_k = p_0 + \dots + p_k\) (et \(s_{-1} = 0\)) : \[ \mathbb{P}(X = k) = \mathbb{P}\big(s_{k-1} < U \le s_k\big) = p_k. \]
Loi discrète : première image
Loi discrète : vidéo
Uniforme sur un intervalle, sur un pavé
On sait simuler une uniforme sur \([0,1]\).
- Sur \([a,b]\) ? On tire \(U\) uniforme sur \([0,1]\) et on renvoie \(a + (b-a)\,U\).
- Sur un pavé \([a_1,b_1] \times \dots \times [a_d,b_d]\) ? On tire indépendamment \(V_i\) uniforme sur \([a_i,b_i]\) et on renvoie \((V_1, \dots, V_d)\).
Les coordonnées d’un point uniforme sur un pavé sont indépendantes : c’est faux pour un disque, une ellipse, un flocon…
Uniforme sur un pavé : première image
Un point uniforme sur le pavé, à partir de deux tirages uniformes sur des segments.
Uniforme sur un pavé : vidéo
On tire \(V_1\) sur \([a_1,b_1]\), puis \(V_2\) sur \([a_2,b_2]\) indépendamment, et on les réunit : \((V_1,V_2)\) est uniforme sur le pavé.
Ellipse : première image
Des points uniformes sur une ellipse. Que dire de leurs deux coordonnées ?
Ellipse : vidéo
La loi de l’ordonnée dépend de l’abscisse : on ne peut pas tirer les deux coordonnées séparément.
Méthode du rejet : le cas uniforme
On veut un point uniforme sur un domaine \(D\).
- Facile si \(D\) est un pavé.
- Que faire si \(D\) est compliqué ?
. . .
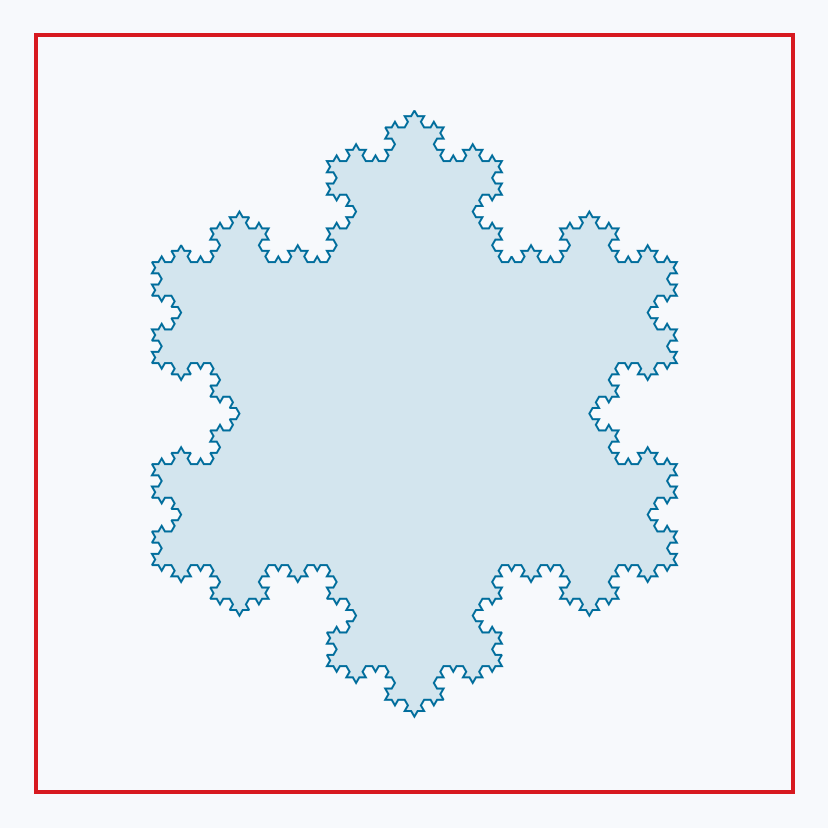
Idée : tirer dans un pavé \(B \supset D\) et ne garder que les points tombés dans \(D\).
Méthode du rejet : algorithme
- simuler \(V\) uniforme sur le pavé \(B \supset D\)
- tant que \(V \notin D\) : simuler un nouveau \(V\) uniforme sur \(B\)
- renvoyer \(V\)
Le point renvoyé est uniforme sur \(D\) : \(\;\mathbb{P}(V \in A \mid V \in D) = \dfrac{|A \cap D|}{|D|}\).
Le nombre de tirages suit une loi géométrique de paramètre \(|D|/|B|\) : il vaut \(|B|/|D|\) en moyenne.
Plus le pavé \(B\) est ajusté à \(D\), plus la méthode est rapide !
Rejet uniforme : première image
Tirer dans le pavé, garder les points tombés dans le flocon. Même nombre de propositions des deux côtés.
Rejet uniforme : vidéo
Tirer dans le pavé, garder les points tombés dans le flocon. Même nombre de propositions des deux côtés.
Fonction de répartition inverse : le principe
Soit \(X\) une variable réelle de fonction de répartition \(F(t) = \mathbb{P}(X \le t)\).
Si \(F\) est bijective et si \(U\) est uniforme sur \([0,1]\) : \[ \mathbb{P}\big(F^{-1}(U) \le t\big) = \mathbb{P}\big(U \le F(t)\big) = F(t), \qquad \forall t \in \mathbb{R}. \]
Donc \(F^{-1}(U)\) a la même loi que \(X\).
Pour simuler \(X\) de fonction de répartition \(F\) : tirer \(U\) uniforme et renvoyer \(F^{-1}(U)\).
Inversion : première image
Inversion : vidéo
On tire \(U\) sur l’axe vertical, on rejoint la courbe de \(F\), on lit \(X = F^{-1}(U)\) sur l’axe horizontal.
Exemple : la loi exponentielle
Loi exponentielle de paramètre \(\lambda > 0\) : densité \(f(x) = \lambda e^{-\lambda x}\,\mathbf{1}_{x \ge 0}\).
\[ F(x) = \begin{cases} 1 - e^{-\lambda x} & \text{si } x \ge 0,\\ 0 & \text{sinon,} \end{cases} \]
\[ F^{-1}(u) = -\frac{1}{\lambda}\ln(1-u), \quad u \in [0,1[. \]
- \(U \leftarrow\)
rand() - renvoyer \(-\dfrac{1}{\lambda}\ln(1-U)\)
\(1-U\) a la même loi que \(U\) : renvoyer \(-\ln(U)/\lambda\) convient aussi.
Extension : l’inverse généralisée
Problème : \(F\) n’est pas toujours bijective (lois discrètes, paliers…).
On définit l’inverse généralisée : \[ G(u) = \inf\{t \in \mathbb{R} : F(t) \ge u\}, \qquad u \in \,]0,1[. \]
Comme \(F\) est croissante et continue à droite : \(\quad G(u) \le t \iff u \le F(t)\).
Donc \(\mathbb{P}\big(G(U) \le t\big) = \mathbb{P}\big(U \le F(t)\big) = F(t)\) : \(G(U)\) a toujours la loi de \(X\).
Inverse généralisée : vidéo
Pour une loi discrète, \(F\) est en escalier : on retrouve exactement l’algorithme des lois à valeurs finies.
Limites de l’inversion
La méthode demande de savoir calculer \(G\).
- Loi gaussienne : \(F(t) = \displaystyle\int_{-\infty}^t \frac{e^{-x^2/2}}{\sqrt{2\pi}}\,dx\) n’a pas d’expression explicite ; idem pour les lois Gamma.
- Lois définies seulement par leur densité \(f\), à une constante près…
Autre idée : revenir à la méthode du rejet, en regardant sous le graphe de la densité.
Sous le graphe d’une densité
Soit \(f\) une densité et \(\mathcal{A}_f = \{(x,y) : 0 \le y \le f(x)\}\) (d’aire \(1\)).
- Si \((Y_1, Y_2)\) est uniforme sur \(\mathcal{A}_f\), alors \(Y_1\) a pour densité \(f\).
- Réciproquement, si \(X\) a pour densité \(f\) et \(U\) est uniforme sur \([0,1]\), indépendante, alors \(\big(X, U f(X)\big)\) est uniforme sur \(\mathcal{A}_f\).
Preuve de 1 : \(\;\mathbb{P}(Y_1 \le t) = \big|\mathcal{A}_f \cap \{x \le t\}\big| = \displaystyle\int_{-\infty}^{t} f(x)\,dx.\)
Sous le graphe : vidéo
Des points uniformes sous le graphe de \(f\)… et leurs abscisses, qui ont pour densité \(f\).
Rejet pour une densité : l’enveloppe
On veut simuler \(X\) de densité \(f\).
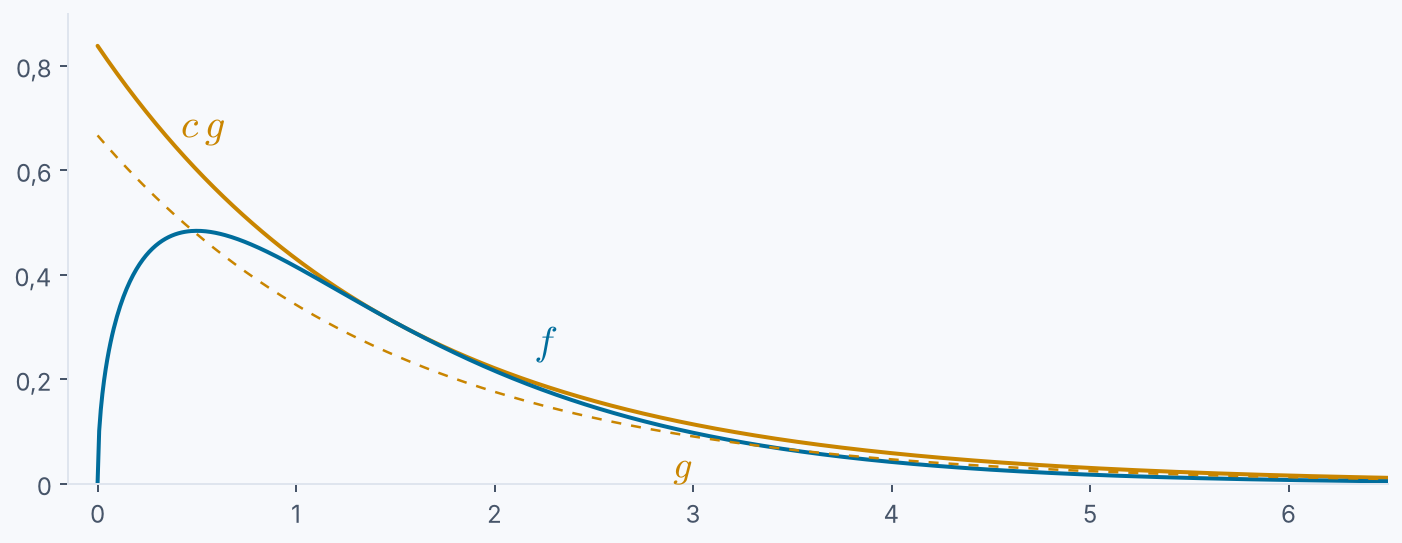
- Trouver une densité \(g\) que l’on sait simuler et une constante \(c\) telles que \[ f(x) \le c\,g(x), \quad \forall x. \]
Exemple : \(f(x) = \tfrac{2}{\sqrt{\pi}}\sqrt{x}\,e^{-x}\) sur \([0, +\infty[\) (loi Gamma de paramètre \(3/2\)), \(\;g(x) = \tfrac23 e^{-2x/3}\) (exponentielle, simulable par inversion), \(\;c = \sqrt{27/(2\pi e)} \approx 1{,}26\).
Rejet pour une densité : algorithme
- Tirer \(Y \sim g\), puis un point uniforme sur le segment \([0, c\,g(Y)]\) : le couple est uniforme sous \(c\,g\).
- Garder \(Y\) si le point est sous \(f\), sinon recommencer.
- répéter
- \(Y \leftarrow\) tirage selon \(g\)
- \(U \leftarrow\)
rand()
- jusqu’à \(c\,U\,g(Y) \le f(Y)\)
- renvoyer \(Y\)
\(Y\) renvoyé a pour densité \(f\). Le nombre d’essais est géométrique de moyenne \(c\) : on veut \(c\) le plus petit possible, donc \(g\) proche de \(f\).
Rejet pour une densité : première image
Rejet pour une densité : vidéo
Partie 2 Simulation de chaînes de Markov
Rappel : chaîne de Markov
Une chaîne de Markov sur un espace d’états \(E\) (fini ou dénombrable) est une suite \((X_n)_{n \ge 0}\) telle que \[ \mathbb{P}\big(X_{n+1} = j \mid X_n = i, X_{n-1}, \dots, X_0\big) = q_{i,j}, \qquad \forall i,j \in E,\ \forall n \ge 0. \]
Sa loi est caractérisée par
- la matrice de transition \(q = (q_{i,j})_{i,j \in E}\) ;
- la loi initiale \(\mu\) de \(X_0\).
La loi de \(X_n\) est \(\mu\,q^n\)… mais la simulation n’utilise jamais \(q^n\) (souvent incalculable) : on avance pas à pas.
Simuler une chaîne de Markov
- simuler \(X_0\) selon \(\mu\)
- \(n \leftarrow 0\)
- tant que on ne s’arrête pas :
- simuler \(X_{n+1}\) selon la ligne \(q_{X_n,\cdot}\) \(\quad\) (algorithme des lois à valeurs finies)
- \(n \leftarrow n + 1\)
Chaque pas ne demande qu’un tirage selon une loi discrète connue.
Un premier exemple
Chaîne sur \(E = \{1, 2, 3, 4\}\) de matrice de transition
\[ q = \begin{pmatrix} 0{,}19 & 0{,}3 & 0{,}5 & 0{,}01 \\ 0 & 0{,}5 & 0{,}49 & 0{,}01 \\ 0{,}3 & 0{,}3 & 0{,}39 & 0{,}01 \\ 0 & 0 & 0 & 1 \end{pmatrix} \]
- Depuis \(1\), \(2\) ou \(3\), on peut toujours partir en \(4\) (probabilité \(0{,}01\)).
- L’état \(4\) est absorbant : on n’en sort plus.
Une trajectoire : première image
Une trajectoire : vidéo
Beaucoup de trajectoires : première image
\(1\,500\) chaînes indépendantes, toutes parties de l’état \(1\).
Beaucoup de trajectoires : vidéo
La répartition des chaînes approche la loi \(\mu\,q^n\) de \(X_n\) : la masse se vide dans l’état absorbant.
Loi invariante
Une loi \(\nu\) sur \(E\) est invariante (ou stationnaire) pour \(q\) si \(\nu\,q = \nu\), c’est-à-dire \(\displaystyle\sum_{i \in E} \nu_i\, q_{i,j} = \nu_j\) pour tout \(j\). Si \(X_0\) suit la loi \(\nu\), alors \(X_n\) suit la loi \(\nu\) pour tout \(n\).
Si \(E\) est fini et si \(q\) est irréductible et apériodique, il existe une unique loi invariante \(\nu\), et pour toute loi initiale \(\mu\) : \[ \mu\,q^n \xrightarrow[n\to\infty]{} \nu . \]
Dans l’exemple précédent, la chaîne n’est pas irréductible : la seule loi invariante est la masse en \(4\), l’état absorbant.
Exemple : la météo
Chaque jour est ensoleillé (\(1\)), nuageux (\(2\)) ou pluvieux (\(3\)), avec \[ q = \begin{pmatrix} 0{,}6 & 0{,}3 & 0{,}1 \\ 0{,}3 & 0{,}4 & 0{,}3 \\ 0{,}2 & 0{,}4 & 0{,}4 \end{pmatrix}. \]
Tous les \(q_{i,j}\) sont \(> 0\) : la chaîne est irréductible et apériodique. On résout \(\nu\,q = \nu\) : \[ \nu = \left(\tfrac{24}{61},\ \tfrac{22}{61},\ \tfrac{15}{61}\right) \approx (0{,}39\ ;\ 0{,}36\ ;\ 0{,}25). \]
À long terme, il pleut environ un jour sur quatre, quel que soit le temps d’aujourd’hui.
Météo : première image
\(1\,500\) chaînes indépendantes, toutes parties de l’état « pluie ».
Météo : vidéo
En quelques pas, la loi de \(X_n\) se stabilise sur \(\nu\)… alors que chaque chaîne continue de bouger.
Exemple : marche aléatoire simple
Chaîne sur \(E = \mathbb{Z}\) de transition \[ q_{i,j} = \begin{cases} \tfrac12 & \text{si } j = i+1 \text{ ou } j = i-1,\\ 0 & \text{sinon.} \end{cases} \]
Autrement dit \(X_n = X_0 + \xi_1 + \dots + \xi_n\), où les \(\xi_k = \pm 1\) sont i.i.d.
Marche aléatoire : vidéo
Une trajectoire, puis \(300\) : l’éventail s’ouvre comme \(\sqrt{n}\).
Exemple : le modèle de Wright-Fisher
Un modèle de génétique des populations pour la dérive génétique.
- \(N\) individus, deux allèles A et a ;
- à chaque génération, chaque enfant choisit son parent au hasard dans la génération précédente, et hérite de son allèle.
Le nombre \(X_n\) d’individus portant A est une chaîne de Markov sur \(\{0, \dots, N\}\) : \[ q_{i,j} = \binom{N}{j}\left(\frac{i}{N}\right)^{j}\left(1 - \frac{i}{N}\right)^{N-j}, \quad \text{i.e.} \quad X_{n+1} \mid X_n = i \;\sim\; \mathrm{Bin}\!\left(N, \tfrac{i}{N}\right). \]
Les états \(0\) et \(N\) sont absorbants : tôt ou tard, un allèle disparaît.
Wright-Fisher : première image
Wright-Fisher : vidéo
Wright-Fisher : trajectoires
\(N = 100\), \(X_0 = 30\) : on peut montrer que \(\mathbb{P}(\text{A est fixé}) = X_0/N = 0{,}3\).
Une écriture générale
Toutes nos chaînes s’écrivent sous la forme \[ X_{n+1} = \Phi\big(X_n, \xi_{n+1}\big), \qquad (\xi_n)_{n \ge 1} \text{ i.i.d., indépendantes de } X_0 . \]
- marche aléatoire : \(\Phi(x, \xi) = x + \xi\), avec \(\xi = \pm 1\) ;
- Wright-Fisher : \(\xi\) = les choix de parents des \(N\) enfants.
Cette écriture garde un sens si \(E = \mathbb{R}\) ou \(\mathbb{R}^d\) : c’est la définition générale d’une chaîne de Markov, et c’est exactement l’algorithme de simulation.
Application : finance
Le cours \(S_k\) d’une action au jour \(k\) (modèle de Black-Scholes en temps discret, pas \(h = 1/250\) an, un jour de cotation) : \[ S_{k+1} = S_k + \mu\, S_k\, h + \sigma\, S_k \sqrt{h}\; Z_{k+1}, \qquad Z_k \text{ i.i.d. } \mathcal{N}(0,1), \] avec \(\mu\) la tendance et \(\sigma\) la volatilité. C’est une chaîne de Markov : \(S_{k+1} = \Phi(S_k, Z_{k+1})\).
Quantité d’intérêt : par exemple le prix d’une option d’achat, qui s’écrit comme une espérance, du type \(\mathbb{E}\big[(S_T - K)^+\big]\) : on l’estimera par Monte-Carlo.
Finance : première image
Chaque jour, un tirage \(Z_{k+1}\) fait avancer la chaîne d’un pas.
Finance : vidéo
Une trajectoire de la chaîne, puis \(300\) trajectoires indépendantes : \(S_T\) est aléatoire.
Application : physique
Plaque carrée, grille \(24 \times 24\) : bord du haut à \(100\) °C, les trois autres à \(0\) °C. Température d’équilibre \(u\) (version discrète de \(\Delta u = 0\)) : \[ u(x) = \frac14 \sum_{y \text{ voisin de } x} u(y) \quad \text{à l'intérieur}, \qquad u = T \text{ sur le bord}. \]
Soit \((X_n)\) la marche aléatoire simple sur la grille, partie de \(x\), et \(\tau\) le premier instant où elle touche le bord. Alors \[ u(x) = \mathbb{E}\big[T(X_\tau)\big]. \]
Quantité d’intérêt : \(u(x)\) en un point, sans résoudre le système linéaire.
Physique : première image
La température au centre de la plaque : une affaire de marche aléatoire.
Physique : vidéo
Chaque marche s’arrête au bord et y lit une température : \(u(x)\) est la moyenne de ces températures.
Partie 3 Monte-Carlo pour l’intégration numérique
Un premier exemple : calcul de \(\pi\)
Un premier exemple : calcul de \(\pi\)
Personne ne « connaît » \(\pi\) : les ordinateurs en stockent une approximation, calculée par des méthodes numériques.
Mais comment ?
Viser au hasard
Tirons un point uniformément dans le carré rouge \([-1{,}5 \,;\, 1{,}5]^2\).
Il tombe dans le disque avec probabilité \[ p = \frac{\text{aire du disque}}{\text{aire du carré}} = \frac{\pi}{9}. \]
Avec \(N\) points : \(\;N_{\text{cercle}} \simeq \dfrac{N\pi}{9}\), \(\;\) c’est-à-dire \[ \pi \simeq 9\,\frac{N_{\text{cercle}}}{N} =: \pi_N. \]
Calcul de \(\pi\) : première image
Calcul de \(\pi\) : vidéo
Quelques questions
- S’approche-t-on vraiment de \(\pi\) ? Peut-on le certifier ?
- Que dire de l’erreur \(|\pi_N - \pi|\) ? À quelle vitesse tend-elle vers \(0\) ?
\[|\pi_N - \pi| \;\sim\; \frac{1}{N} \;?\]
\[|\pi_N - \pi| \;\sim\; \frac{1}{N^2} \;?\]
\[|\pi_N - \pi| \;\sim\; \frac{1}{\ln N} \;?\]
Pour répondre : deux théorèmes fondamentaux.
Loi forte des grands nombres
Soit \((X_i)_{i \ge 1}\) une suite de variables aléatoires réelles i.i.d. telles que \(\mathbb{E}\big[|X_1|\big] < \infty\). Alors la moyenne des \(n\) premiers tirages \[ S_n = \frac{1}{n}\sum_{i=1}^{n} X_i \] converge presque sûrement vers \(\mathbb{E}[X_1]\) : \[ S_n \xrightarrow[n\to\infty]{\text{p.s.}} \mathbb{E}[X_1]. \]
Pour \(\pi\) : \(X_i = 9\,\mathbf{1}_{\{\text{le } i\text{-ème point est dans le disque}\}}\), \(\;\mathbb{E}[X_1] = 9\,p = \pi\) : oui, \(\pi_N \to \pi\).
LGN : vidéo
Moyennes de lancers d’un dé équilibré : chaque suite finit par se coller à \(\mathbb{E}[X] = 3{,}5\).
Théorème central limite
On s’intéresse maintenant à l’erreur \(S_n - \mathbb{E}[X_1]\), lorsque \(\sigma^2 = \mathrm{Var}(X_1) < \infty\).
\[ S_n - \mathbb{E}[X_1] \xrightarrow[n\to\infty]{} 0 \]
\[ {\color{#d71920}{\sqrt{n}}}\,\big(S_n - \mathbb{E}[X_1]\big) \xrightarrow[n\to\infty]{\textbf{en loi}} \mathcal{N}\big(0, \sigma^2\big) \]
\[ E_n := {\color{#d71920}{\sqrt{n}}}\,\frac{S_n - \mathbb{E}[X_1]}{{\color{#d71920}{\sigma}}} \xrightarrow[n\to\infty]{\textbf{en loi}} \mathcal{N}(0,1) \]
(TCL) Si les \(X_i\) sont i.i.d. de variance \(\sigma^2 \in \,]0,\infty[\), alors pour tous \(a < b\), \[ \mathbb{P}\big(a \le E_n \le b\big) \xrightarrow[n\to\infty]{} \int_a^b \frac{e^{-z^2/2}}{\sqrt{2\pi}}\,dz. \]
Conséquence : l’erreur de Monte-Carlo
Pour \(n\) grand, \(\quad S_n - \mathbb{E}[X_1] \;\approx\; \dfrac{\sigma}{\sqrt{n}}\,Z, \quad Z \sim \mathcal{N}(0,1)\), donc \[ \mathbb{P}\left(\big|S_n - \mathbb{E}[X_1]\big| \le 1{,}96\,\frac{\sigma}{\sqrt{n}}\right) \xrightarrow[n\to\infty]{} 0{,}95. \]
L’erreur de Monte-Carlo décroît en \(\dfrac{\sigma}{\sqrt{n}}\) : ni \(1/n\), ni \(1/n^2\), ni \(1/\ln n\).
- pour gagner une décimale, il faut \(100\) fois plus de tirages ;
- deux leviers : augmenter \(n\)… ou diminuer \(\sigma\) ;
- cette vitesse ne dépend pas de la dimension du problème.
L’entonnoir
Ici \(\sigma^2 = 81\,p(1-p)\) avec \(p = \pi/9\), soit \(\sigma \approx 4{,}29\).
Intervalle de confiance
En pratique \(\sigma\) est inconnu : on l’estime avec les mêmes tirages, \[ \hat\sigma_n^2 = \frac{1}{n-1}\sum_{i=1}^{n}\big(X_i - S_n\big)^2 . \]
Le TCL reste vrai en remplaçant \(\sigma\) par \(\hat\sigma_n\), d’où l’intervalle de confiance à 95 % : \[ \left[\, S_n - 1{,}96\,\frac{\hat\sigma_n}{\sqrt{n}} \;,\; S_n + 1{,}96\,\frac{\hat\sigma_n}{\sqrt{n}} \,\right]. \]
Monte-Carlo fournit une estimation et une mesure de sa précision : on peut certifier le résultat, au niveau de confiance choisi.
Généraliser : intégrales et espérances
- Étant donnée \(H : \mathbb{R}^d \to \mathbb{R}\) et un domaine \(D \subset \mathbb{R}^d\), calculer \[ \int_D H(x)\,dx . \] Exemple : \(\displaystyle\int_{-1}^{1} \frac{dx}{1 + 100\,x^2}\) ?
- Étant donnée une variable aléatoire \(X\), calculer \(\mathbb{E}[X]\). Exemples : le taux de retour aux joueurs d’une machine à sous, la probabilité de gagner avec une main donnée au Texas hold’em…
Méthode naïve
Soit \((U_i)_{i\ge1}\) i.i.d. uniformes sur \(D\), de densité \(\dfrac{1}{|D|}\mathbf{1}_D\).
Alors \[ \int_D H(x)\,dx = |D| \times \mathbb{E}\big[H(U_1)\big] \qquad\text{et, par la LGN,}\qquad \mathbb{E}\big[H(U_1)\big] \simeq \frac{1}{n}\sum_{i=1}^{n} H(U_i). \]
Si l’on sait tirer des points \(U_i\) uniformes et indépendants sur \(D\), \[ \frac{|D|}{n}\sum_{i=1}^{n} H(U_i) \xrightarrow[n\to\infty]{} \int_D H(x)\,dx, \] avec une erreur de l’ordre de \(|D|\,\sigma_H/\sqrt{n}\), où \(\sigma_H^2 = \mathrm{Var}\big(H(U_1)\big)\).
Méthode naïve : première image
\(\int_{-1}^{1} \frac{dx}{1 + 100\,x^2} = \frac{\arctan 10}{5} \approx 0{,}2942\) : chaque tirage \(U_i\) apporte une contribution \(H(U_i)\).
Méthode naïve : vidéo
\(\int_{-1}^{1} \frac{dx}{1 + 100\,x^2} = \frac{\arctan 10}{5} \approx 0{,}2942\) : chaque tirage \(U_i\) apporte une contribution \(H(U_i)\).
Comparaison avec les méthodes déterministes
- Méthode des rectangles (point milieu) en dimension \(d\) : avec \(n\) évaluations, une grille de pas \(h = n^{-1/d}\), et une erreur en \(h^2 = n^{-2/d}\).
- Monte-Carlo : une erreur en \(\sigma/\sqrt{n}\), quelle que soit la dimension.
En dimension \(1\) ou \(2\) : les méthodes déterministes gagnent. Dès que \(d > 4\) : Monte-Carlo l’emporte, et l’écart se creuse avec \(d\).
Fléau de la dimension : figure
\(\int_{[0,1]^d} e^{-(x_1 + \dots + x_d)}\,dx = (1 - e^{-1})^d\) : erreur relative en fonction du nombre d’évaluations.
Calcul d’une espérance
Si l’on sait simuler \(X\), le simulateur fournit \(X_1, X_2, \dots\) i.i.d. de même loi que \(X\), et \[ \frac{1}{n}\sum_{i=1}^{n} X_i \simeq \mathbb{E}[X]. \]
En particulier, une probabilité est une espérance : \(\;\mathbb{P}(A) = \mathbb{E}\big[\mathbf{1}_A\big]\).
Tout ce que l’on sait simuler, on sait en estimer les moyennes et les probabilités, même sans aucune formule : files d’attente, modèles d’assurance, réactions en chaîne, jeux de hasard…
Retour à la physique : la plaque chauffée
Avec \(n\) marches indépendantes partant de \(x\) : \[ \hat u_n(x) = \frac1n \sum_{i=1}^{n} T\big(X^{(i)}_{\tau_i}\big) = 100 \times \frac{\text{nombre de marches sorties par le haut}}{n}. \]
- Au centre, \(u = 25\) °C par symétrie : les quatre bords jouent le même rôle, et si chacun était chauffé à son tour, la somme des quatre températures vaudrait \(100\) °C.
- Avec \(n = 10\,000\) marches (environ \(170\) pas chacune) : \(\hat u_n = 25{,}4 \pm 0{,}9\) °C.
Chaque point s’estime séparément : utile si l’on ne veut \(u\) qu’en quelques points, ou si le domaine est compliqué, ou en grande dimension.
Plaque : première image
On se concentre sur un seul point \(x\), hors du centre, où \(u(x) \approx 38{,}1\) °C.
Plaque : vidéo
Chaque marche part de \(x\) et s’arrête au bord : \(\hat u_n(x)\) vaut \(100\) °C fois la proportion de marches sorties par le haut.
Là aussi, des questions
S’approche-t-on vraiment de \(\displaystyle\int_D H(x)\,dx\) ? Peut-on le certifier ? Oui : LGN et intervalles de confiance.
Que dire de l’erreur ? Avec quelle vitesse ? En \(\sigma/\sqrt{n}\) : TCL.
- Peut-on améliorer l’erreur ? On ne peut pas changer \(\sqrt{n}\)… mais on peut changer \(\sigma\) : réduction de variance.
Retour à \(\int_{-1}^{1} H(x)\,dx\)
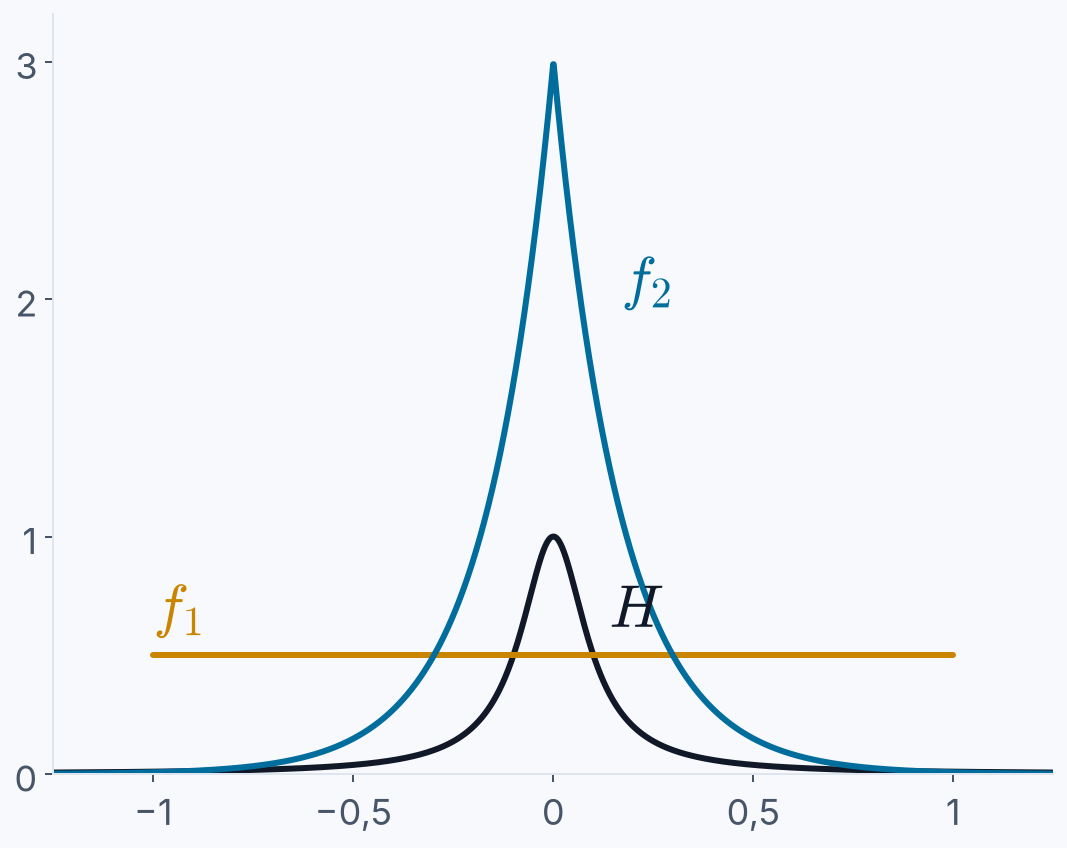
- \(H(x) = \dfrac{1}{1 + 100\,x^2}\) est concentrée autour de \(0\).
- Avec \(f_1\) uniforme, la plupart des tirages tombent là où \(H\) est petite : ils apportent peu.
. . .
Idée : tirer plus souvent là où \(H\) est grande, par exemple selon \[ f_2(x) = 3\,e^{-6|x|}. \]
Problème !
Soit \((X_i)\) i.i.d. de densité \(f_2\). La LGN donne \[ \frac{1}{n}\sum_{i=1}^{n} H(X_i) \xrightarrow[n\to\infty]{} \mathbb{E}\big[H(X_1)\big] = \int_{\mathbb{R}} H(x)\,f_2(x)\,dx \;\neq\; \int_{-1}^{1} H(x)\,dx \;!!! \]
Solution : réécrire l’intégrale comme une espérance sous \(f_2\) : \[ \int_D H(x)\,dx = \int_{\mathbb{R}} \frac{H(x)}{f_2(x)}\,\mathbf{1}_D(x)\,f_2(x)\,dx = \mathbb{E}\!\left[\frac{H(X_1)}{f_2(X_1)}\,\mathbf{1}_D(X_1)\right]. \]
Échantillonnage préférentiel : \(\displaystyle\frac{1}{n}\sum_{i=1}^{n}\frac{H(X_i)}{f_2(X_i)}\,\mathbf{1}_D(X_i) \longrightarrow \int_D H(x)\,dx\). Attention aux endroits où \(f_2\) est petite : les poids \(H/f_2\) y explosent.
Échantillonnage préférentiel : première image
Échantillonnage préférentiel : vidéo
Le gain
Écart-type de l’estimateur, \(\sigma/\sqrt{n}\) (valeurs exactes) :
| Densité d’échantillonnage | \(f_1\) (uniforme) | \(f_2\) (préférentielle) |
|---|---|---|
| \(n = 10\) | \(0{,}151\) | \(0{,}025\) |
| \(n = 100\) | \(0{,}048\) | \(0{,}008\) |
| \(n = 1\,000\) | \(0{,}015\) | \(0{,}003\) |
\(\sigma_1 \approx 0{,}477\) et \(\sigma_2 \approx 0{,}080\) : la variance est divisée par \(36\). Avec \(f_2\), il faut \(36\) fois moins de tirages pour la même précision.
Pourquoi ça marche ? Comment choisir \(f\) ?
La variance de l’estimateur vaut \[ \mathrm{Var}\!\left(\frac{H(X)}{f(X)}\mathbf{1}_D(X)\right) = \int_D \frac{H(x)^2}{f(x)}\,dx - I^2, \qquad I = \int_D H(x)\,dx . \]
- Si \(H \ge 0\) et \(f = H / I\) : variance nulle ! … mais il faudrait connaître \(I\).
- En pratique : choisir \(f\) simulable et de même forme que \(|H|\), strictement positive là où \(H \ne 0\), avec des queues pas plus légères que celles de \(H\). Ici, \(f = 5\,e^{-10|x|}\), trop étroite, ne diviserait la variance que par \(1{,}6\).
Même idée pour \(\pi\) : avec le carré ajusté \([-1,1]^2\) (\(\pi \simeq 4\,N_{\text{cercle}}/N\)), la variance est \(6{,}8\) fois plus petite qu’avec \([-1{,}5\,;1{,}5]^2\).
Partie 4 Monte-Carlo pour la simulation
Motivation : le ferromagnétisme
- Un morceau de fer peut être aimanté : ses atomes alignent leurs moments magnétiques.
- Au-dessus de la température de Curie (\(770\,°\mathrm{C}\) pour le fer), l’aimantation disparaît.
Un modèle microscopique très simple peut-il expliquer cette transition de phase ?
Modèle à deux particules
Deux particules, chacune portant un spin \(\sigma_i \in \{-1, +1\}\). L’espace d’états a \(|E| = 4\) éléments.
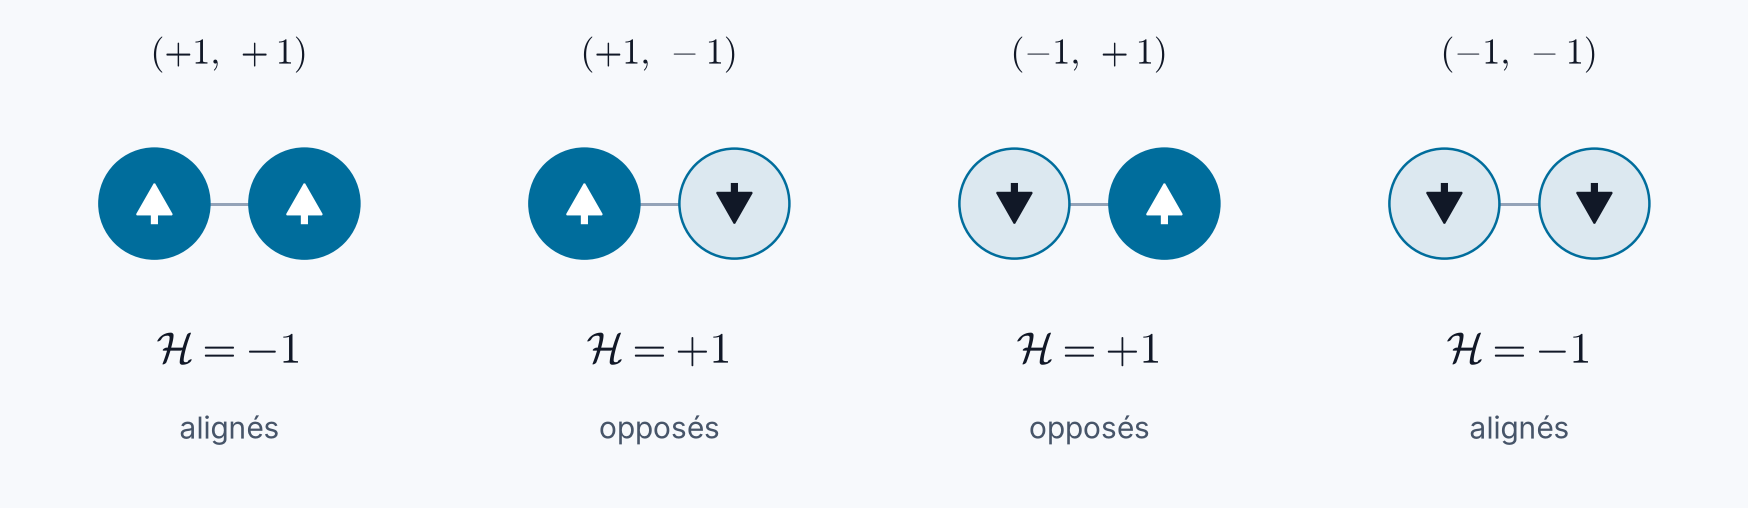
L’énergie du système : \(\;\mathcal{H}(\sigma) = -\,\sigma_1\,\sigma_2\). Des spins alignés ont une énergie plus basse.
Modèle à \(N^2\) particules : le modèle d’Ising
Des particules sur une grille \(N \times N\) : \[ \sigma : \{1, \dots, N\}^2 \to \{-1, +1\}, \qquad |E| = 2^{N^2}. \]
Énergie : \[ \mathcal{H}(\sigma) = -\sum_{i \sim j} \sigma_i\,\sigma_j , \] où \(i \sim j\) signifie que \(i\) et \(j\) sont voisins sur la grille (distance \(1\)).
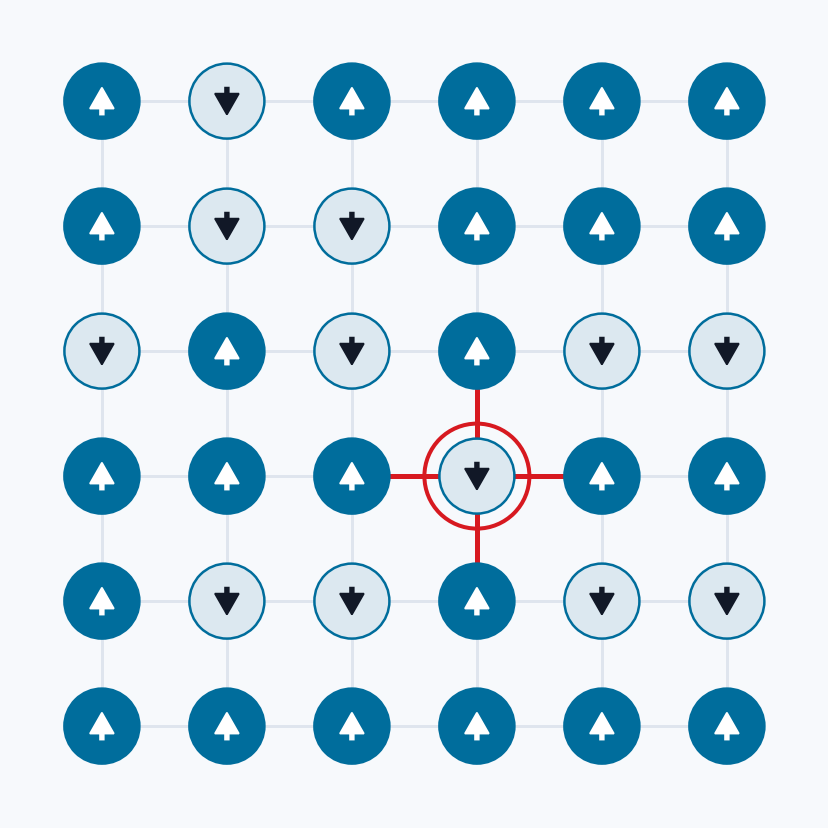
un site et ses \(4\) voisins
Loi du système : la mesure de Gibbs
La physique statistique dit que le système est dans l’état \(\sigma\) avec probabilité \[ P_T(\sigma) = \frac{1}{Z_T}\exp\!\left(-\frac{\mathcal{H}(\sigma)}{T}\right), \qquad Z_T = \sum_{\sigma \in E}\exp\!\left(-\frac{\mathcal{H}(\sigma)}{T}\right), \] où \(T\) est la température.
- \(T\) petit : les états de basse énergie (spins alignés) dominent.
- \(T\) grand : presque uniforme, les spins sont désordonnés.
L’aimantation \(\;M = \dfrac{1}{N^2}\displaystyle\sum_{i} \sigma_i \in [-1,1]\) mesure l’alignement.
Transition de phase
Existe-t-il une température critique \(T_c\) telle que, pour \(N\) grand, \[ \mathbb{E}\,|M| > 0 \ \text{ si } T < T_c, \qquad \mathbb{E}\,|M| \to 0 \ \text{ si } T > T_c \;? \]
- En dimension \(1\) : pas de transition de phase (Ising, 1925).
- En dimension \(2\) : transition de phase (Peierls, 1936), et valeur exacte de \(T_c\) (Kramers et Wannier, 1941 ; Onsager, 1944) : \[ T_c = \frac{2}{\ln(1 + \sqrt{2})} \approx 2{,}269. \]
L’objectif
L’objectif : obtenir des tirages de \(P_T\), ici sur un réseau \(200 \times 200\) : deux tirages à chacune des trois températures.
Quatre particules : la grille \(2 \times 2\)
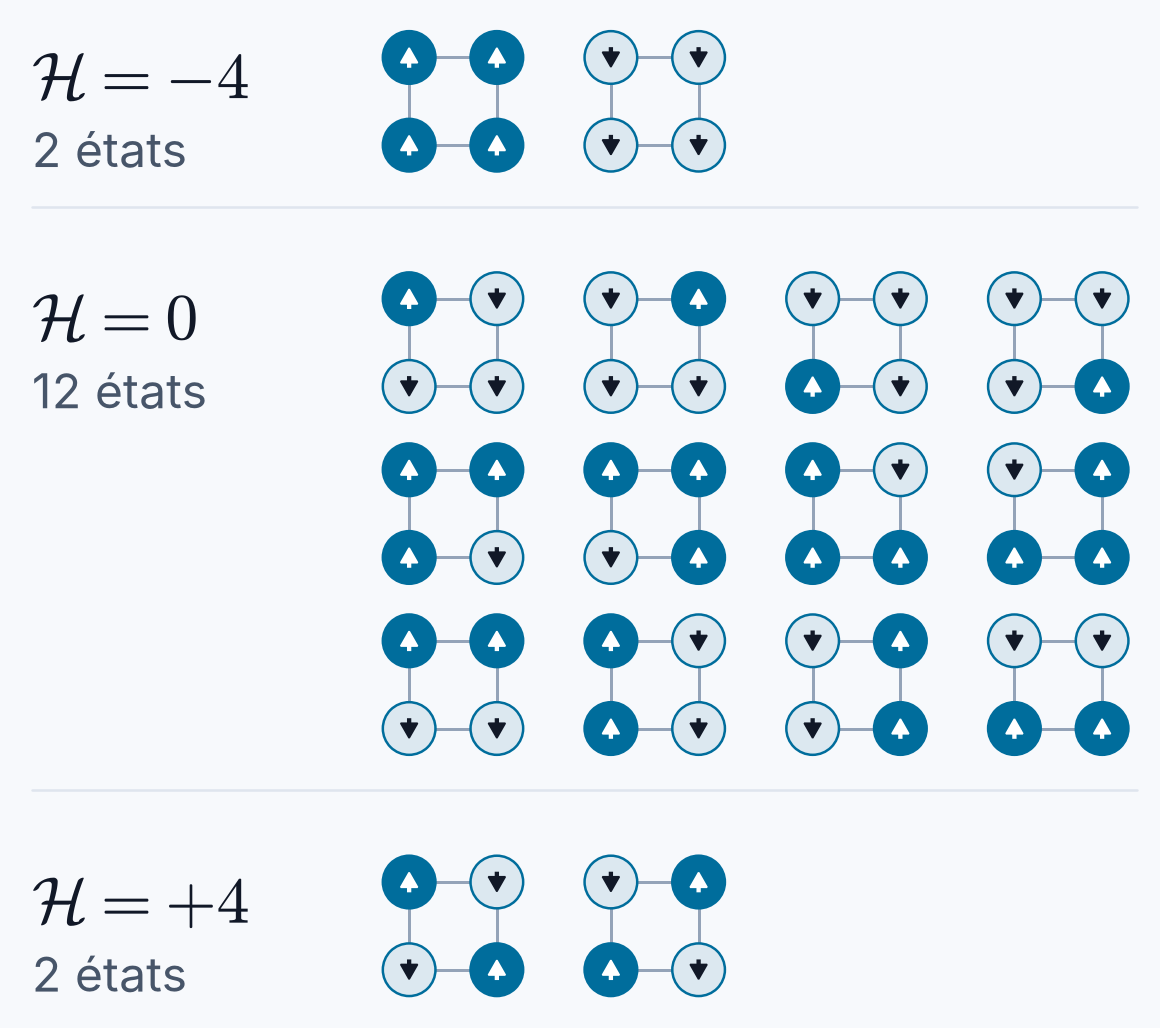
\(2^4 = 16\) états et \(4\) paires de voisins : l’énergie vaut \(-4\), \(0\) ou \(+4\).
. . .
\[ Z_T = 2\,e^{4/T} + 12 + 2\,e^{-4/T} \approx 27{,}05 \quad (T = 2). \]
| \(\mathcal{H}(\sigma)\) | \(-4\) | \(0\) | \(+4\) |
|---|---|---|---|
| nombre d’états | \(2\) | \(12\) | \(2\) |
| \(P_T(\sigma)\) | \(0{,}273\) | \(0{,}037\) | \(0{,}005\) |
. . .
Encore faisable à la main… mais chaque particule ajoutée double le nombre d’états.
Le nombre d’états explose
| grille | particules | nombre d’états | \(P_T\) de l’état le plus probable |
|---|---|---|---|
| \(1 \times 2\) | \(2\) | \(4\) | \(0{,}37\) |
| \(2 \times 2\) | \(4\) | \(16\) | \(0{,}27\) |
| \(4 \times 4\) | \(16\) | \(65\,536\) | \(0{,}08\) |
| \(6 \times 6\) | \(36\) | \(\approx 6{,}9 \cdot 10^{10}\) | \(0{,}02\) |
| \(10 \times 10\) | \(100\) | \(\approx 1{,}3 \cdot 10^{30}\) | \(1{,}1 \cdot 10^{-3}\) |
| \(20 \times 20\) | \(400\) | \(\approx 2{,}6 \cdot 10^{120}\) | \(2{,}5 \cdot 10^{-8}\) |
| \(1\) g de fer | \(\approx 10^{22}\) | \(2^{10^{22}}\) | \(< 10^{-10^{20}}\) |
À \(T = 2\). L’état le plus probable : tous les spins alignés.
Trop d’états pour les énumérer, et chacun a une probabilité quasi nulle, même le plus probable. On ne peut ni énumérer \(E\), ni même calculer \(Z_T\) : il faut une autre idée.
Metropolis-Hastings : l’idée
La simulation directe de \(P\) est hors de portée. L’algorithme de Metropolis-Hastings utilise une chaîne de Markov.
- Construire une chaîne de Markov \((X_n)\) sur \(E\) telle que \[ X_n \xrightarrow[n\to\infty]{\textbf{en loi}} P, \qquad\text{i.e.}\qquad \mathbb{P}(X_n = \sigma) \simeq P(\sigma) \text{ pour } n \text{ grand}. \]
- Simuler cette chaîne (partie 2 !).
Les ingrédients
On veut simuler une variable aléatoire \(X\) de loi \(P(x) = \mathbb{P}(X = x)\) sur un ensemble fini \(E\).
- La loi cible \(P\), connue à une constante près suffit.
- Un noyau de proposition \(q : E \times E \to [0,1]\), c’est-à-dire une matrice de transition :
- irréductible : on peut aller de tout état à tout état ;
- que l’on sait simuler.
L’algorithme
- (initialisation) \(\; x \leftarrow x_0 \in E\)
- tant que on ne s’arrête pas :
- (proposition) \(\; y \leftarrow\) tirage selon \(q(x, \cdot)\)
- (probabilité d’acceptation) \(\; \alpha \leftarrow \min\left\{1,\ \dfrac{P(y)\,q(y,x)}{P(x)\,q(x,y)}\right\}\)
- \(U \leftarrow\)
rand() - si \(U < \alpha\) : \(\; x \leftarrow y\) \(\quad\) (on accepte, sinon on reste en \(x\))
Seul le rapport \(P(y)/P(x)\) intervient : la constante de normalisation (\(Z_T\) pour Ising) disparaît !
Metropolis : première image
Metropolis : vidéo
Comment choisir \(q\) ? Quand s’arrêter ?
- Choix de \(q\) : un compromis.
- pas trop « timide » : presque tout est accepté, mais la chaîne explore lentement ;
- pas trop « audacieux » : presque tout est rejeté, la chaîne reste sur place.
- Quand s’arrêter ?
- jeter un temps de chauffe : les premières itérations dépendent du point de départ ;
- surveiller la convergence : traces, plusieurs chaînes indépendantes…
Taille du pas : vidéo
Application au modèle d’Ising
- Proposition : choisir un site uniformément et retourner son spin. \(q\) est symétrique : \(q(\sigma, \sigma') = q(\sigma', \sigma) = 1/N^2\).
- Acceptation : \[ \alpha = \min\left\{1,\ \exp\!\left(-\frac{\mathcal{H}(\sigma') - \mathcal{H}(\sigma)}{T}\right)\right\}. \] On accepte toujours si l’énergie baisse ; sinon avec probabilité \(e^{-\Delta\mathcal{H}/T}\).
- \(\Delta\mathcal{H}\) ne fait intervenir que le site choisi et ses \(4\) voisins : chaque itération coûte \(O(1)\), même pour un réseau immense.
Merci pour votre attention
Introduction aux méthodes de Monte-Carlo
Comment simuler ce système ?
Avec l’algorithme des lois à valeurs finies, il faut calculer \(P_T(\sigma)\) pour chaque état \(\sigma\). Essayons avec \(2\) particules, à \(T = 2\).
\[ Z_T = 2\,e^{1/T} + 2\,e^{-1/T} = 2\,e^{1/2} + 2\,e^{-1/2} \approx 4{,}51 . \]
On découpe \([0,1]\) en \(4\) intervalles de longueurs \(0{,}366\) ; \(0{,}134\) ; \(0{,}134\) ; \(0{,}366\), et on tire \(U\) : facile.